Aller au contenu

Case study · aetherwx (ex maritime-atlas)

AetherWX — l'orchestre multi-source

Atlas live qui agrège une quinzaine de sources externes (AIS, météo NOAA + Météo-France, radars nationaux, satellites NASA / EUMETSAT, foudre) sur un globe MapLibre time-scrubable. Une vingtaine de pods k3s, cluster GeoServer 3.0.1 à 3 replicas, alerts engine RabbitMQ topic. Un projet personnel en domaine maritime, bâti sur des sources de données ouvertes. Scaffold initial : 0 ligne de code humaine, ~23 commits en 2 jours — ce qui suit couvre aussi les quatre mois de prod derrière.

Où en est le projet — septembre 2026

Cette page a été écrite au moment du scaffold (mai 2026) puis complétée sprint après sprint. Trois choses ont changé assez pour périmer ce qu'on lit plus bas ailleurs sur le site — le résumé, avant le détail :

  • L'hébergement : la prod ne tourne plus sur « Mini-Blue » (un k3s dans WSL2, qui gelait tous les deux jours), mais sur dark-blue, un serveur bare-metal monté début septembre — Ubuntu 26.04, Ryzen 9 9900X, 64 Go DDR5, NVMe 3,6 To, RTX 4080 (dédiée au transcodage Plex, pas au GIS), k3s v1.36.4 + ArgoCD en GitOps. Migration le 03/09/2026, après trois semaines de site down.
  • GeoServer 3.0.1 en prod depuis le 08/09 (GeoTools 35.1, GWC 2.0.1, Tomcat 11, Java 21, ImageN) — 3 replicas, catalog et data dir centralisés en PostgreSQL, cache de tuiles partagé sur object storage S3.
  • Un harnais de non-régression qui rejoue une matrice de 26 combinaisons layer×style toutes les 6 heures dans le cluster, et une matrice générée en parsant les sources du frontend — donc incapable de dériver en silence. Le détail est ici.

Le reste de la page raconte le fonctionnel et les pièges, dans l'ordre où ils sont tombés.

Aperçu visuel

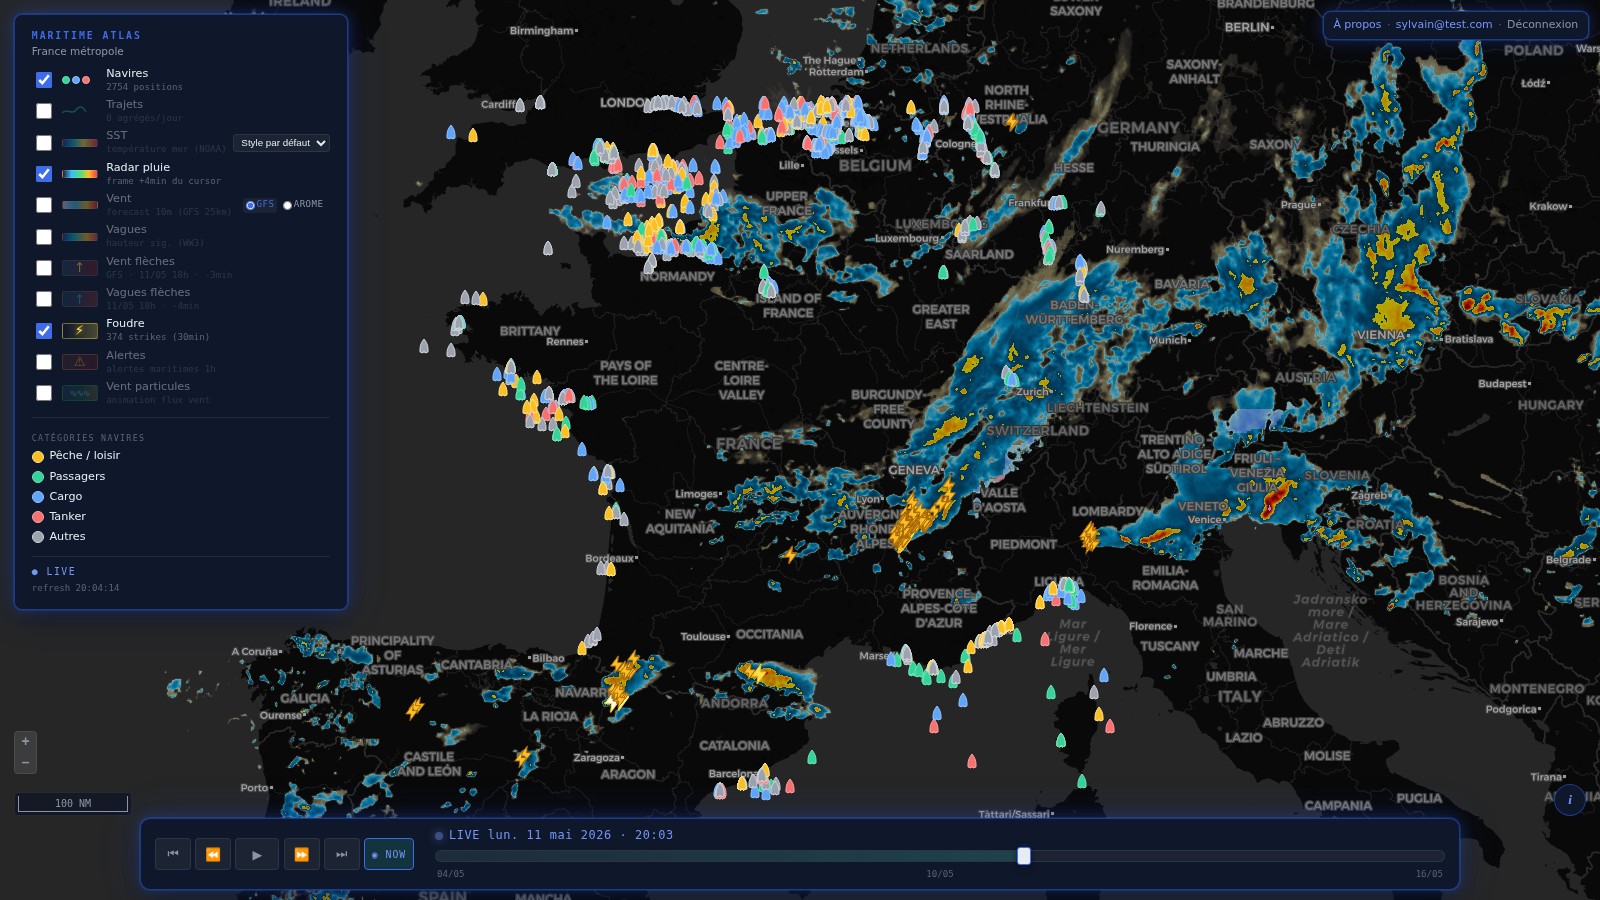
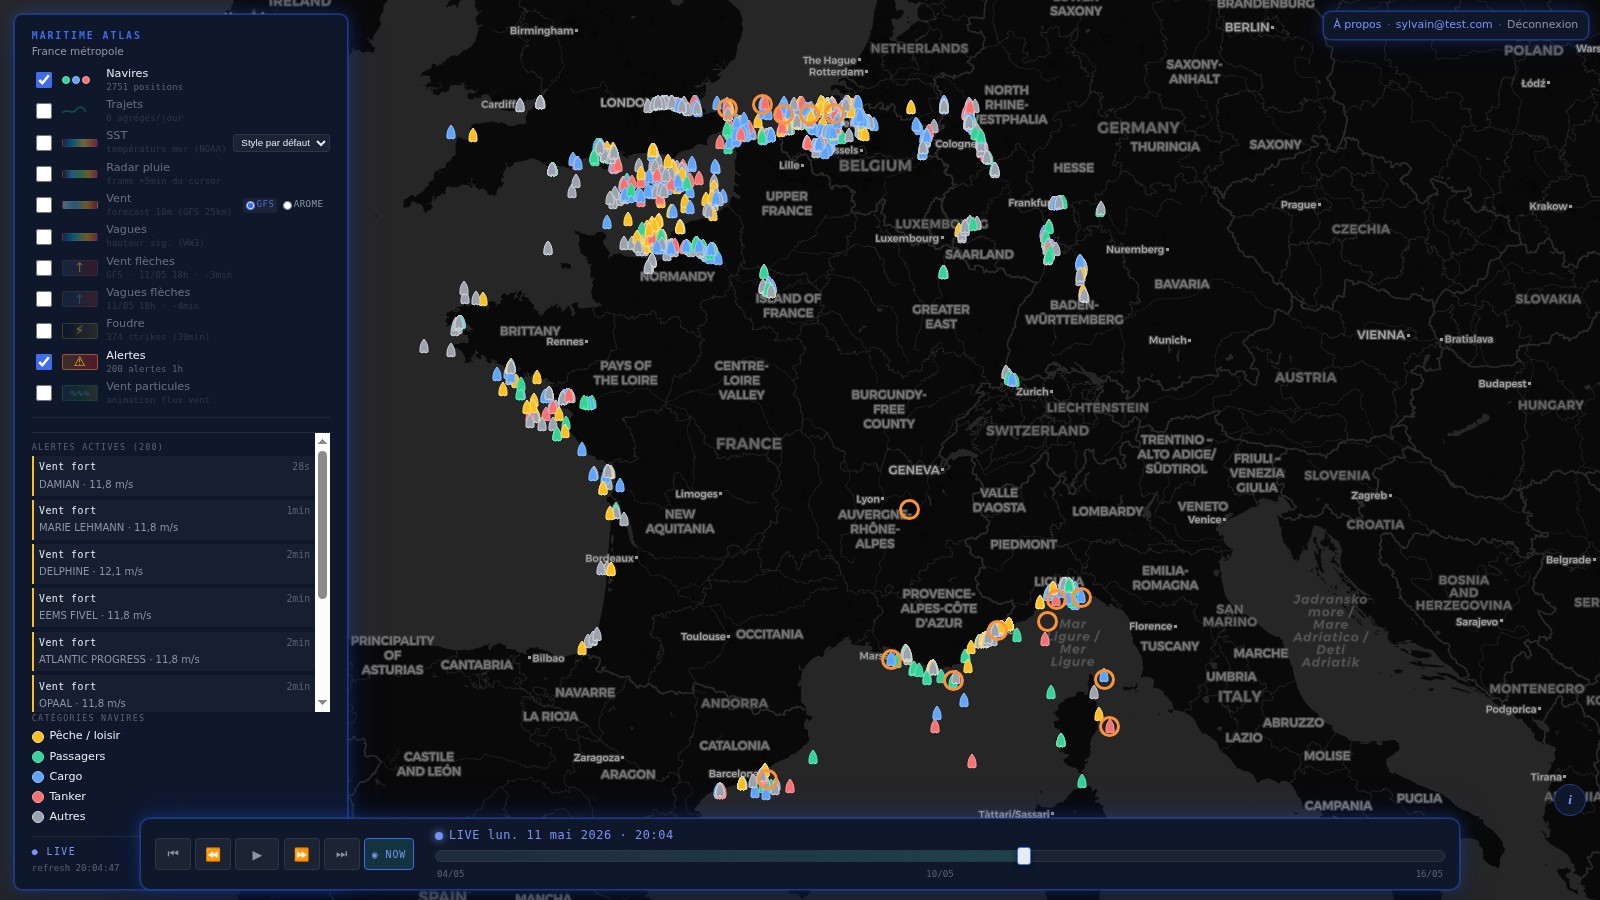
Une carte unique, une quarantaine de bascules réparties en sept sections (Maritime, Observation, Satellites, Radar, Forecast, Hydrologie, Sources). Le slider temporel en bas pilote tout — navires passés/présents, météo forecast, radars, satellites. Voici les principales layers en isolation, puis l'animation des particules de vent (effet style windy.com).

Captures prises en mai 2026, du temps de la carte 2D OpenLayers. La carte est depuis un globe MapLibre (projection sphère, particules de vent en custom layer WebGL) : mêmes données, même pilotage temporel, rendu différent.

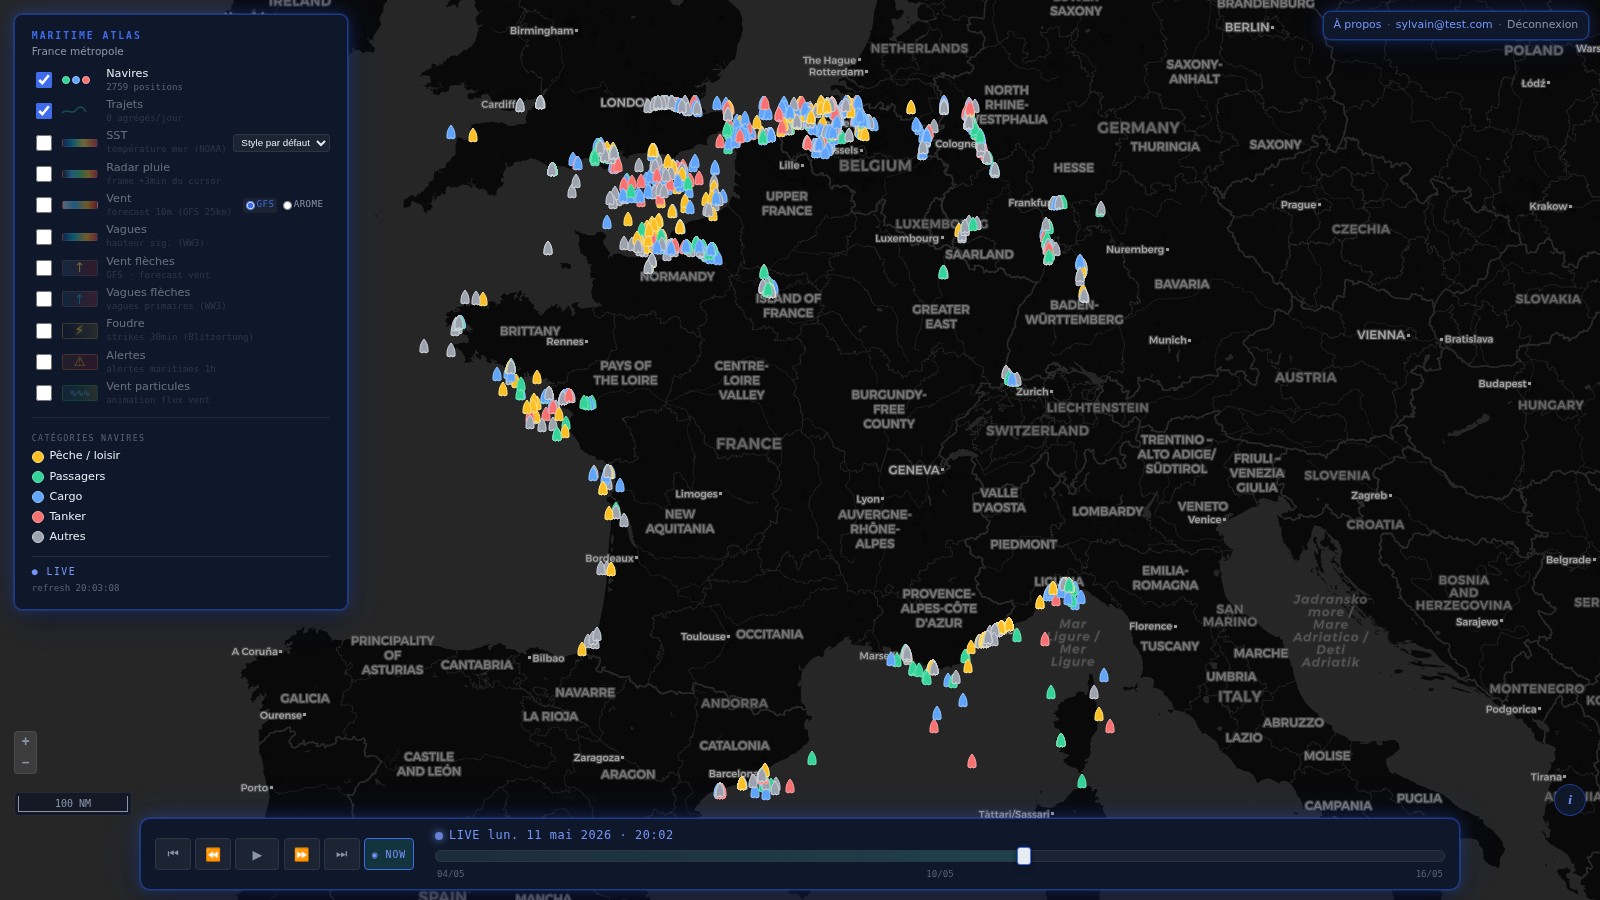
Navires AIS live + trajets daily aggregés
Navires AIS live (2500+ positions) + trajets daily agrégés. Chaque couleur = catégorie de bateau (cargo bleu, tanker rose, pêche jaune, passenger vert).
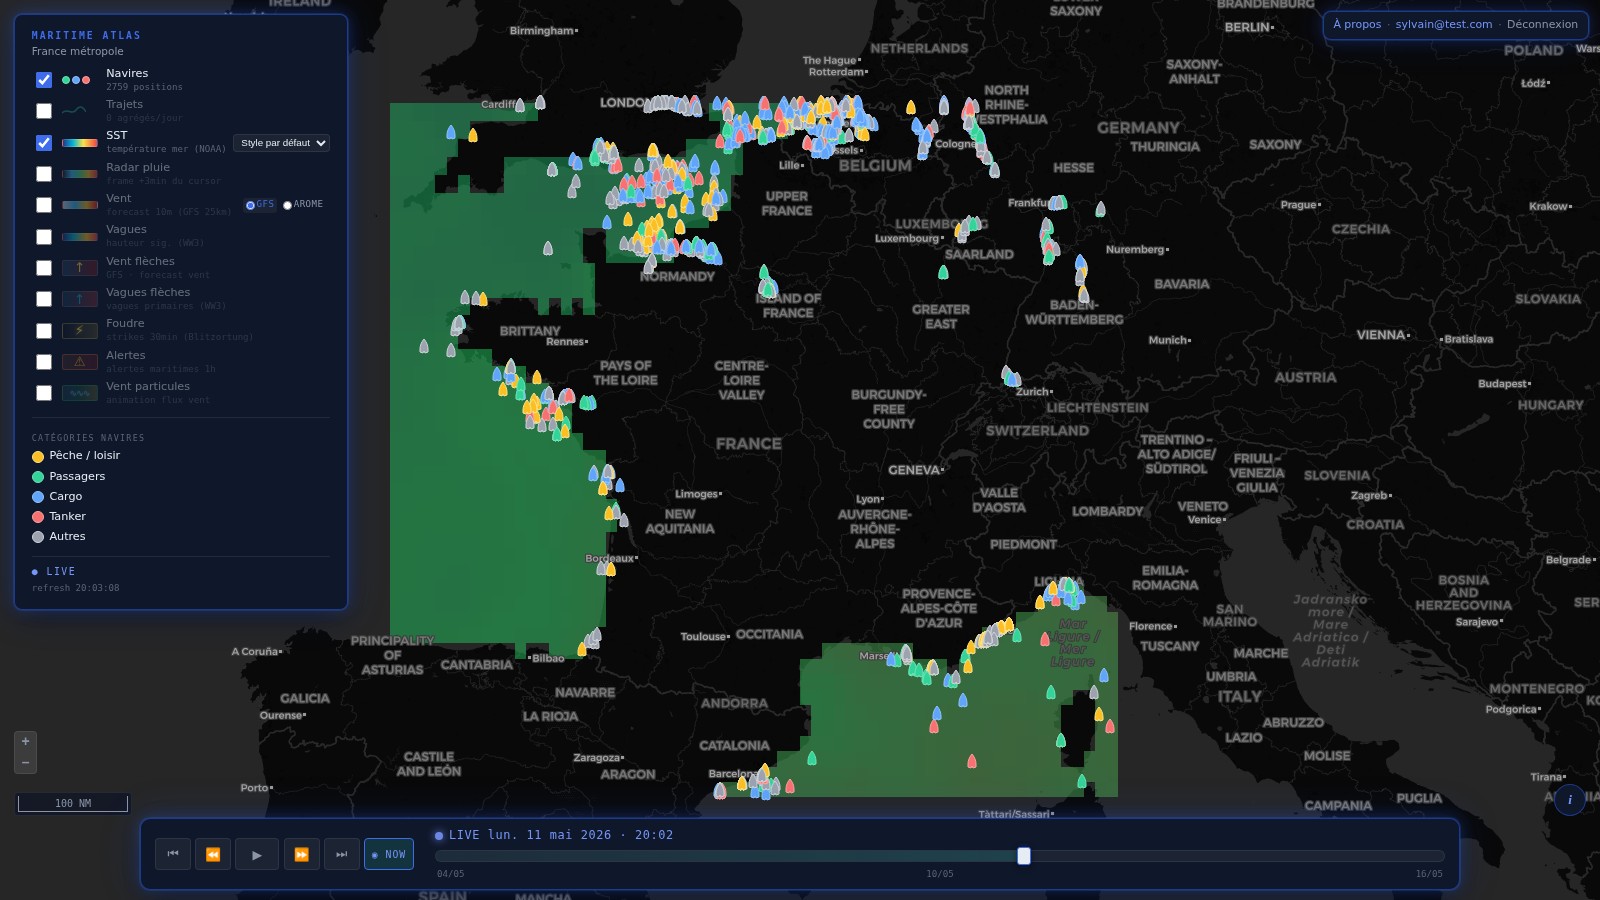
SST — température mer NOAA OISST
SST (température de surface de la mer) — NOAA OISST quotidien, gradient bleu→cyan→vert→jaune→rouge (-2°C → 30°C).
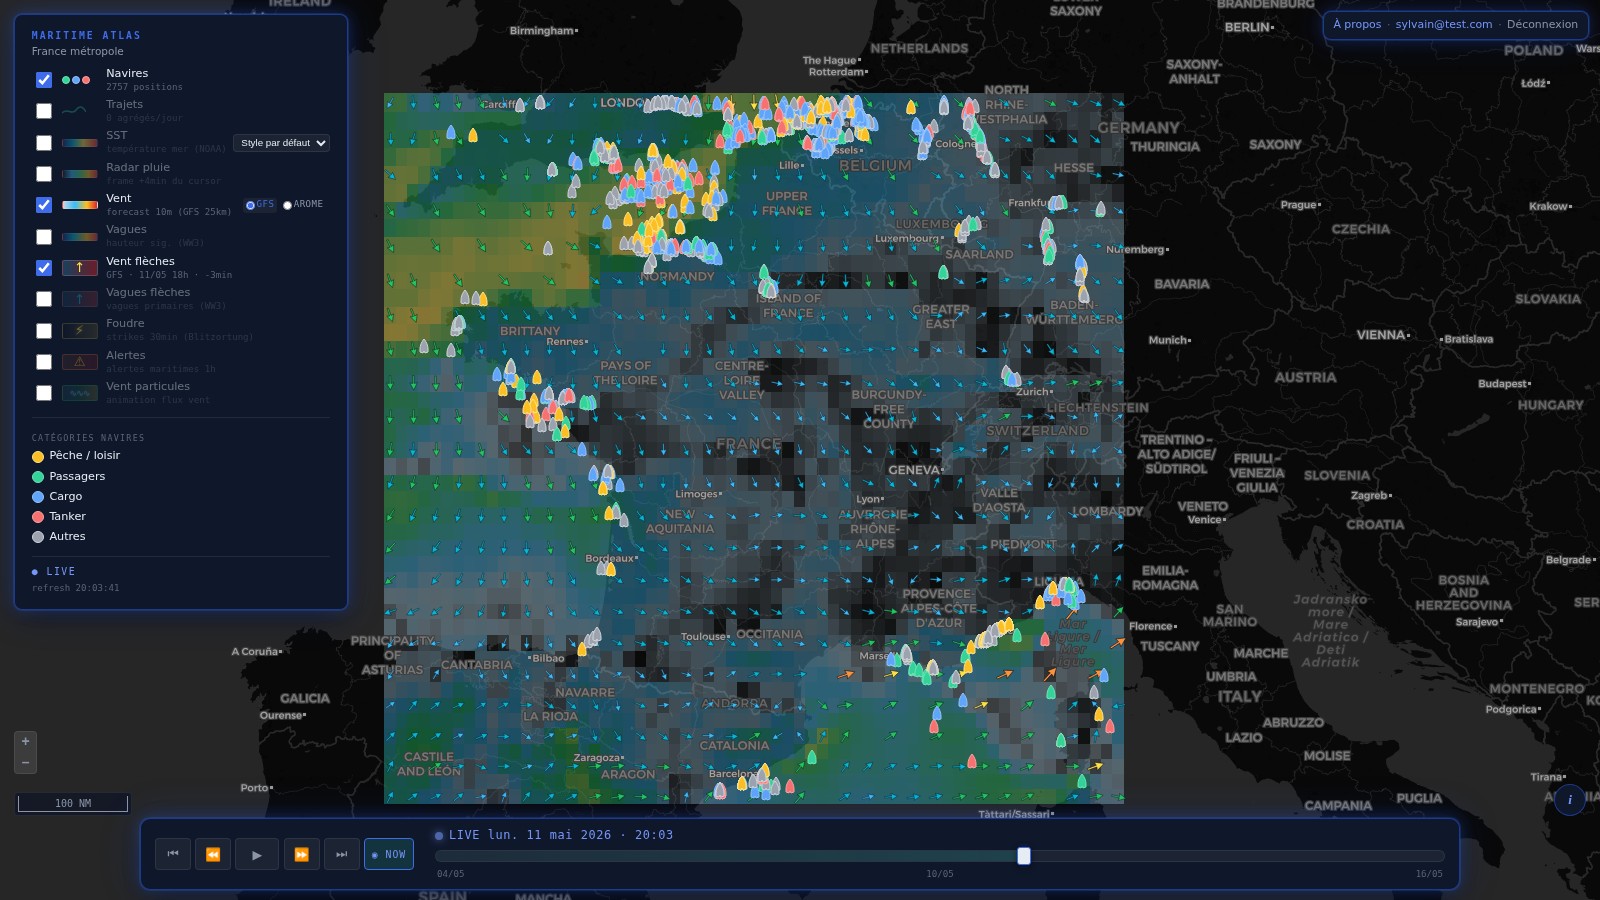
Vent raster + flèches directionnelles
Vent (GFS) — raster magnitude + flèches directionnelles sample par 2×2 cellules grille. Sélecteur GFS / AROME inline.
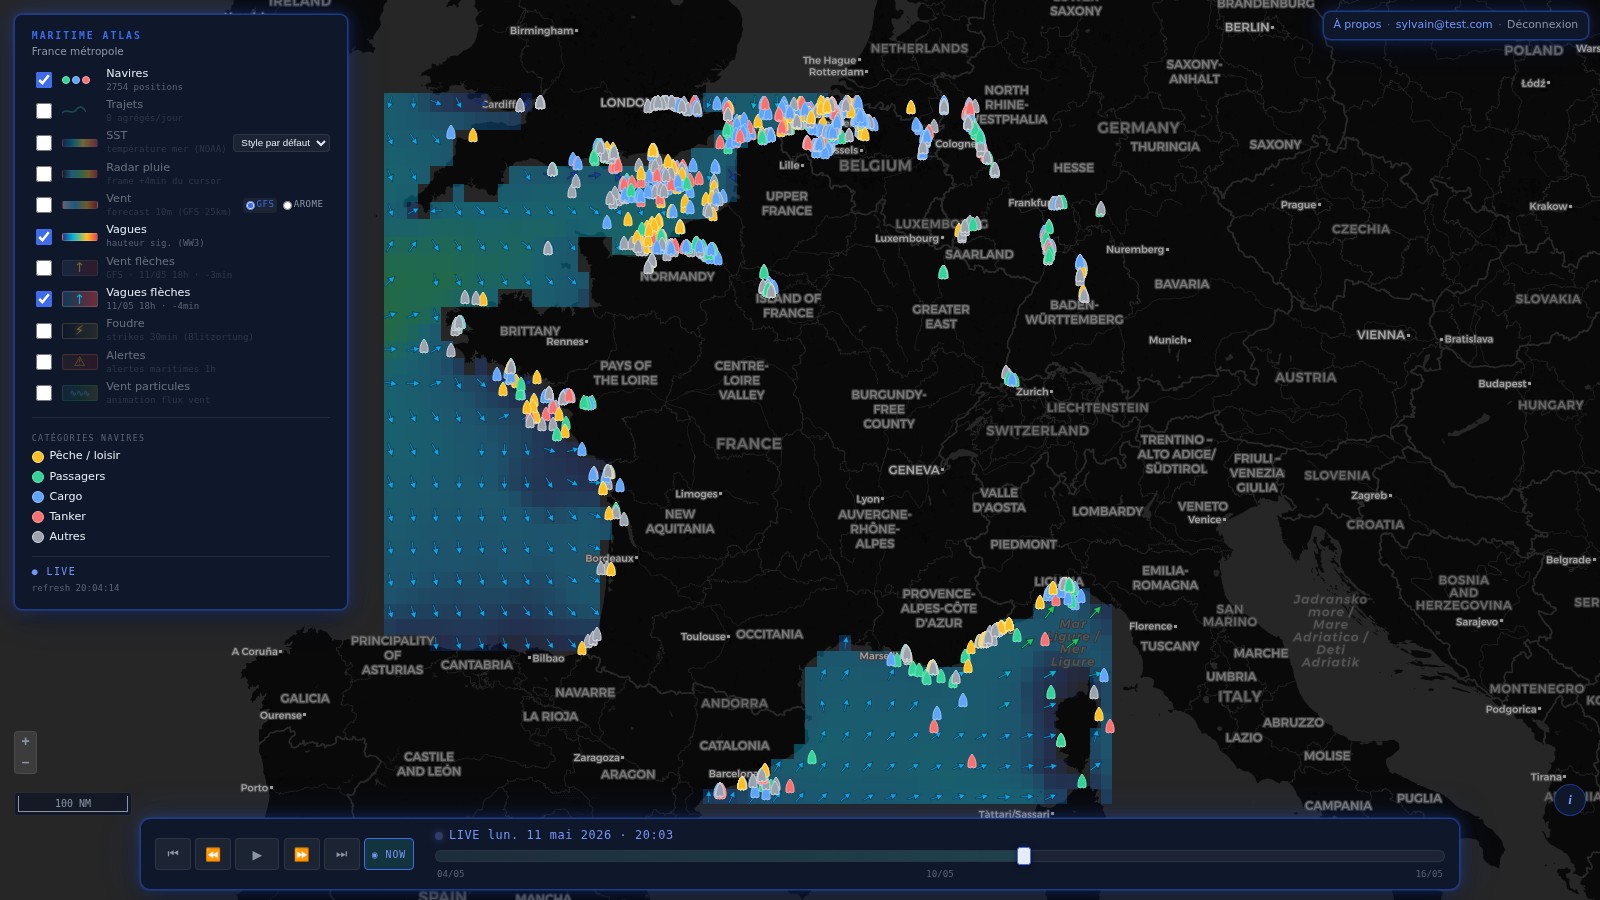
Vagues hauteur + direction (WaveWatch III)
Vagues — NOAA WaveWatch III. Raster hauteur sig. + flèches direction primaire DIRPW. Land mask = pas de flèches sur la terre.
Radar pluie + foudre live
Radar pluie (RainViewer, XYZ tiles time-aware) + Foudre live (Blitzortung WSS, ~30 strikes/30s en bbox FR pendant un orage). Yellow halos = strikes <5min, ambre = <30min.
Panel alertes maritimes — Vent fort sur cargos / tankers
Alerts engine — règles RMQ qui croisent ais.positions + wind grid + lightning.strike. Ici : 17 alertes "Vent fort" sur cargos / tankers (MSC CALYPSO, MSC ALIYA, etc. à 10-16 m/s).
Particules vent style windy.com — à l'époque 1500 particules canvas 2D, advectées par interpolation IDW sur les 4 plus proches voisins de la grille GFS. Depuis le passage au globe, elles sont portées en WebGL (custom layer MapLibre, 3000 particules par défaut, port du webgl-wind de Mapbox sous licence ISC).

Pourquoi ce projet

Je travaillais sur des plateformes géospatiales de météo — stations de mesure et aéroports. J'aime le pattern des services qui communiquent par bus de messages, et j'avais envie d'en refaire un pour moi, dans un domaine volontairement éloigné de mon travail. Maritime est venu naturellement : AIS gratuit (aisstream.io), modèles météo libres NOAA, et un panel de sources visualisables très large pour quelqu'un qui aime mettre des données sur des cartes.

Périmètre initial : bbox France métropole [-6, 41, 10, 51.5] — Manche + Atlantique + Méditerranée + Corse. Il a débordé depuis : l'emprise par défaut est l'Europe élargie [-15, 35, 30, 65], et les layers cascade (satellites NASA GIBS, radars nord-américains, précipitations IMERG) sont globales. Le tout sur un slider temporel qui pilote la quarantaine de layers avec un engine d'alertes RMQ qui croise vessel + vent + foudre en temps réel.

Architecture — vue d'ensemble

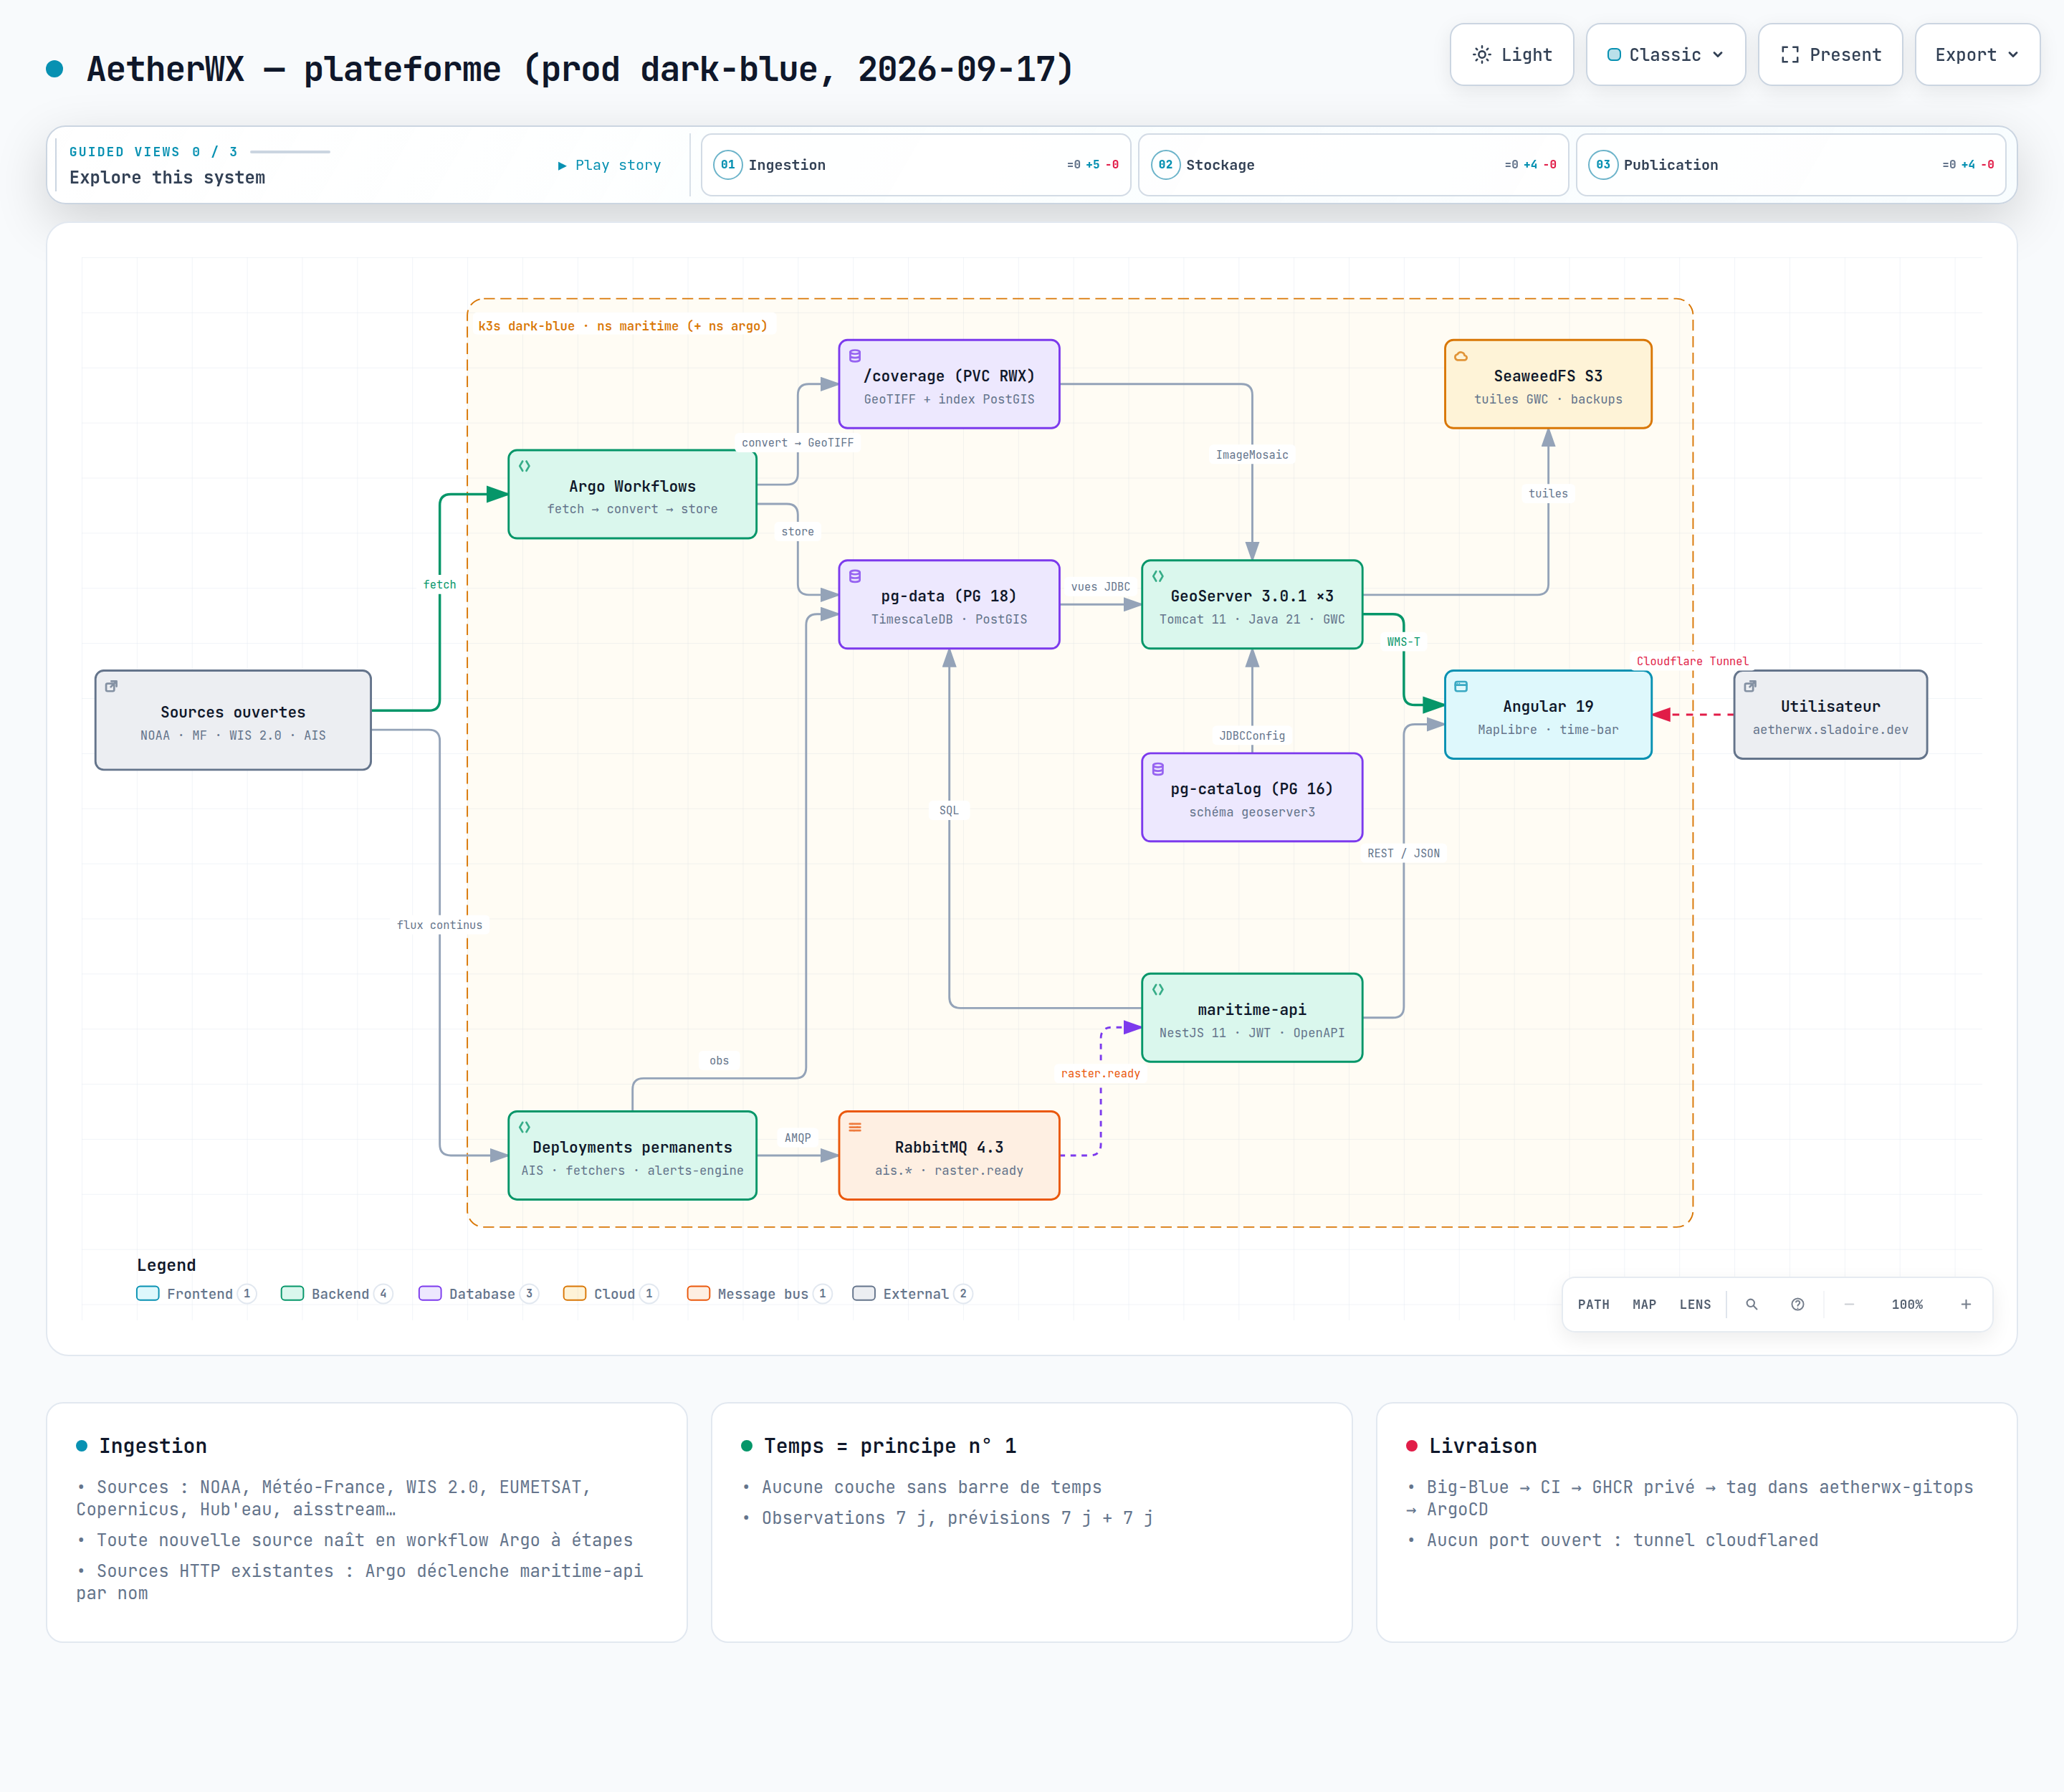
AetherWX — plateforme : sources ouvertes, Argo Workflows et Deployments d'ingestion, PVC /coverage, pg-data PostgreSQL 18 TimescaleDB, RabbitMQ, GeoServer 3.0.1 ×3, pg-catalog, maritime-api NestJS, SeaweedFS S3, frontend Angular 19, utilisateur via Cloudflare Tunnel
État de la prod dark-blue au 2026-09-17. Diagramme Archify — cliquer pour la version interactive (vues guidées Ingestion / Stockage / Publication, trace amont-aval, export). Le frontend n'attaque que GeoServer (WMS-T) et l'API ; toute l'ingestion est en amont.
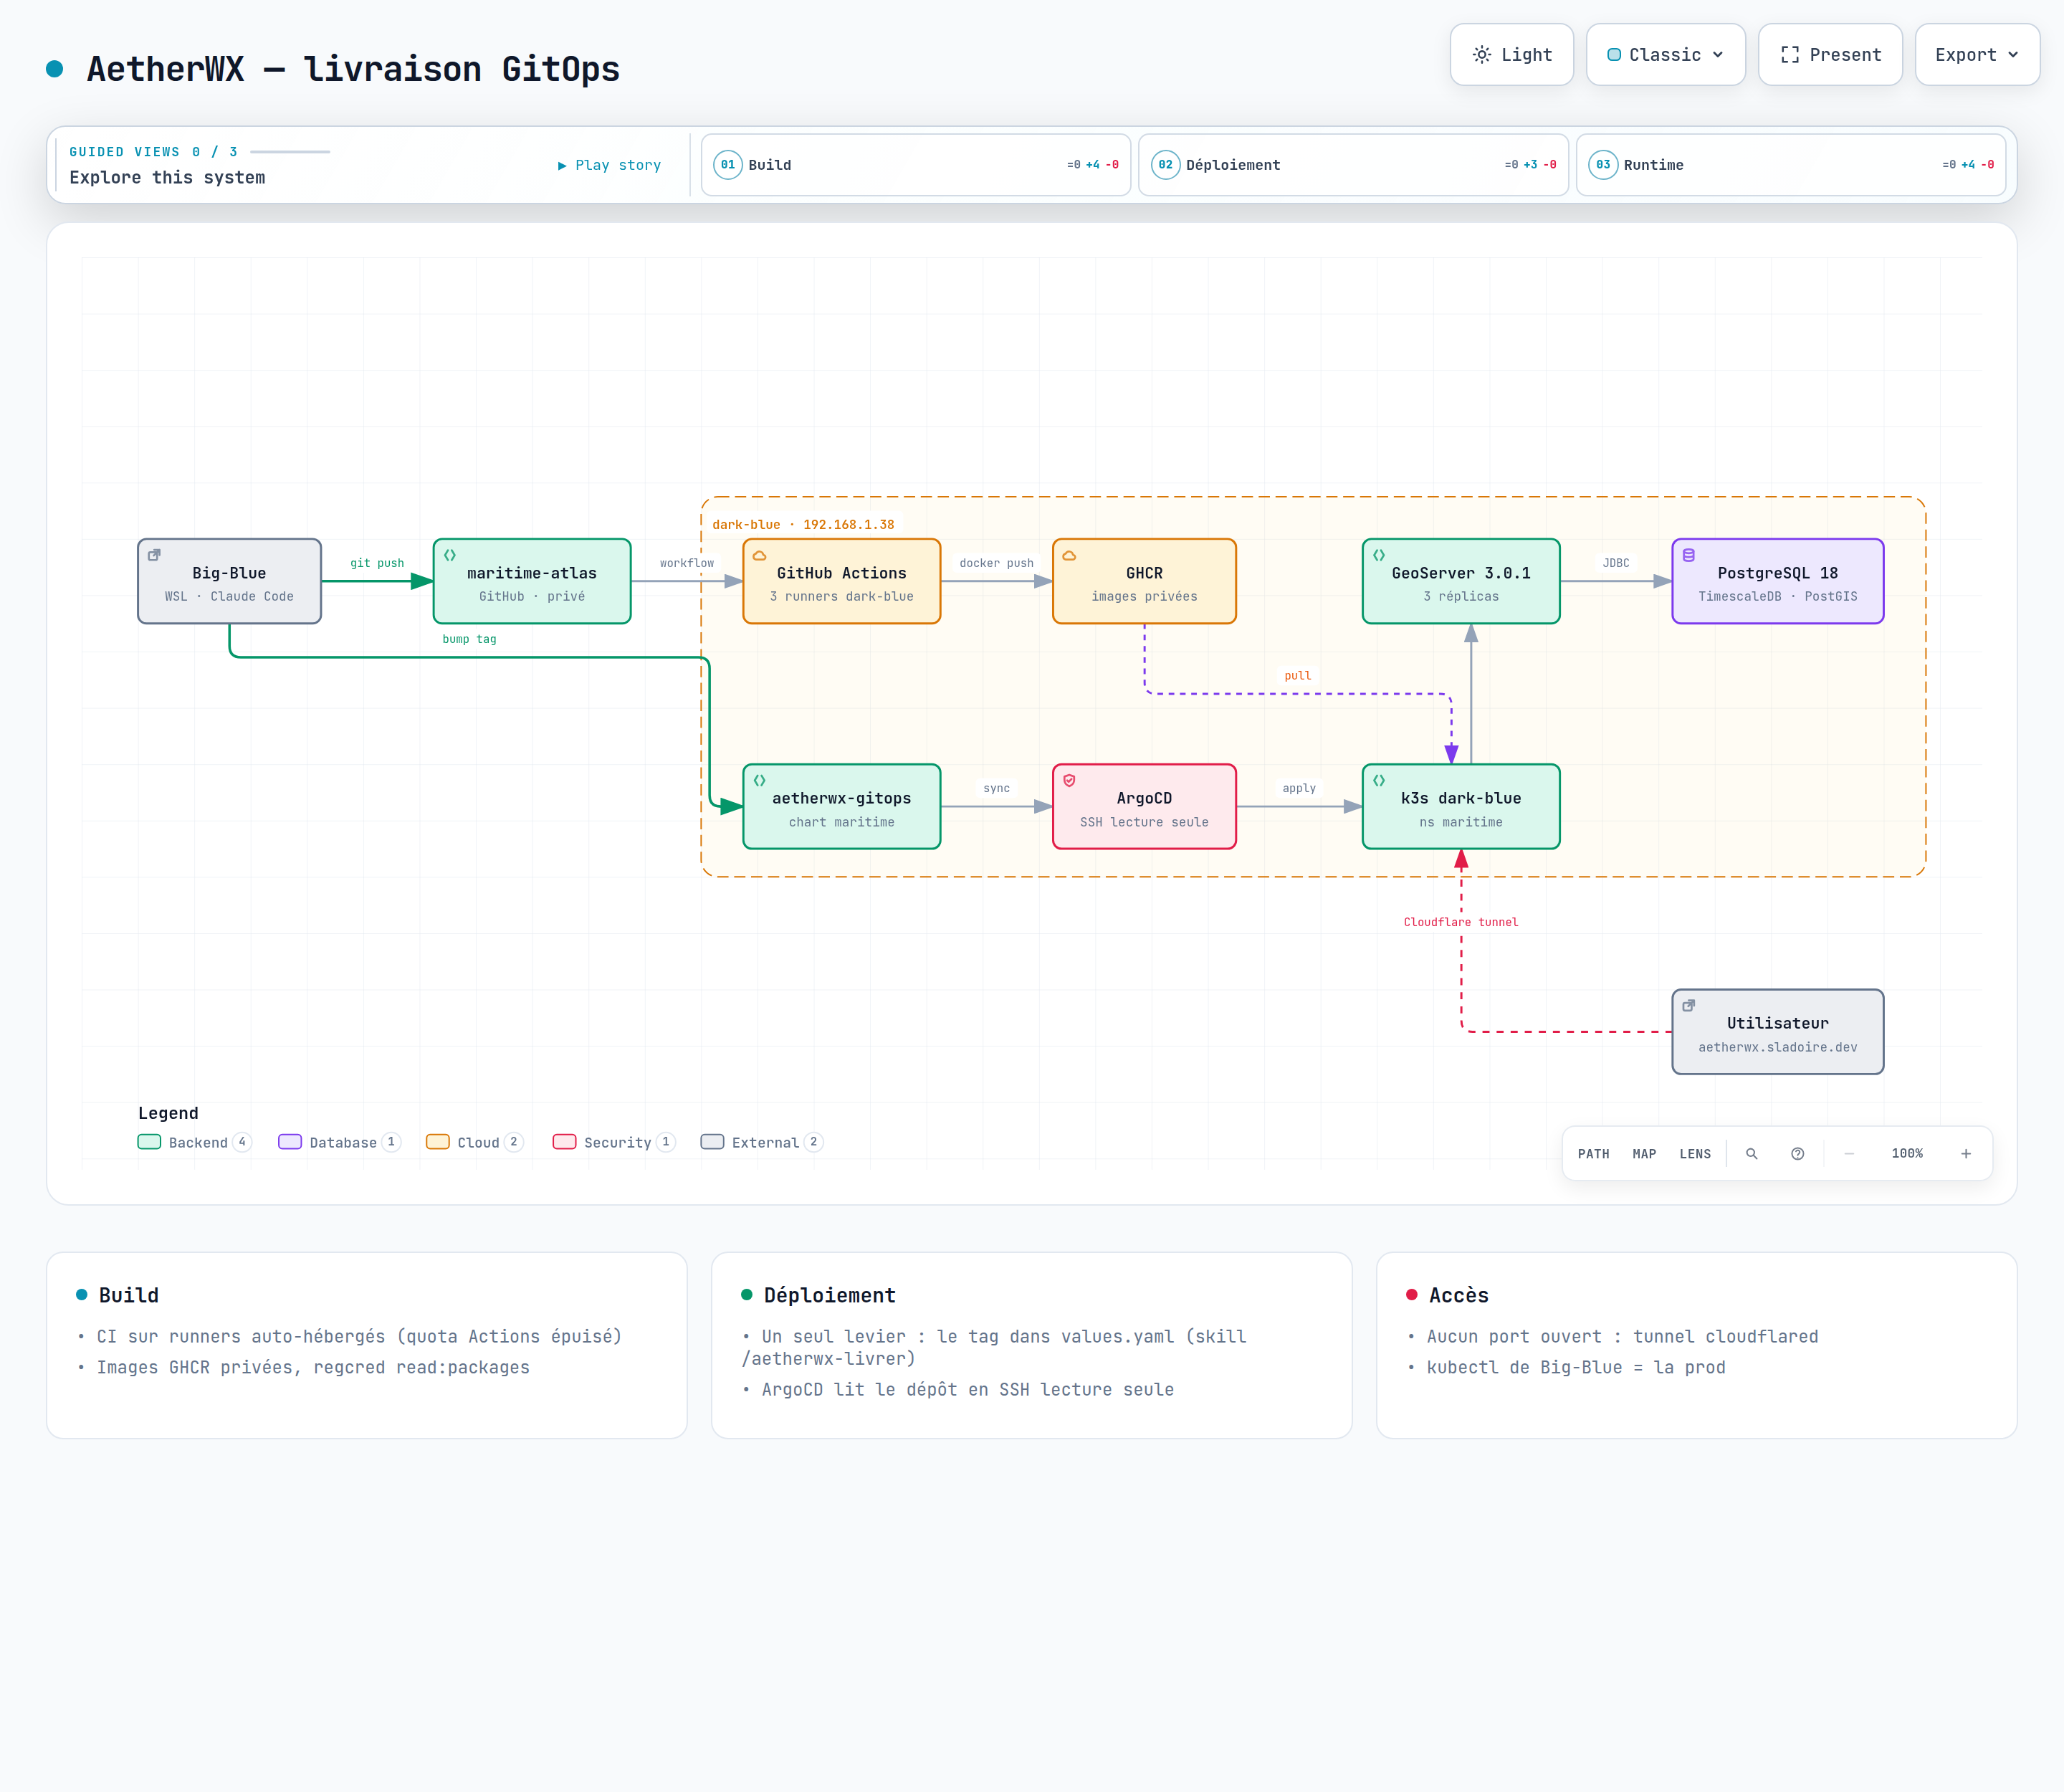
AetherWX — livraison GitOps : Big-Blue → maritime-atlas → GitHub Actions sur runners auto-hébergés → GHCR privé → bump du tag dans aetherwx-gitops → ArgoCD → k3s dark-blue
La chaîne de livraison : un seul levier déploie, le tag sha-… dans le values.yaml du chart. ArgoCD lit le dépôt GitOps en SSH lecture seule ; aucun port ouvert, tout passe par le tunnel Cloudflare.

L'arête importante : le frontend ne tape qu'un seul backend de données — l'alias DNS interne geoserver:8080 (un Service K8s ClusterIP load-balancé sur les 3 replicas GeoServer synchronisés par Hazelcast) — plus l'API NestJS pour l'auth, les profils et les dossiers. Toute l'ingestion est privée au namespace maritime : Argo Workflows orchestre par défaut (fetch → convert → store, une étape visible par conteneur), les flux continus (AIS, foudre) gardent leur Deployment, et les sources HTTP historiques sont déclenchées par nom via maritime-api. Deux bases CloudNativePG distinctes : pg-data (PostgreSQL 18, TimescaleDB, PostGIS) pour les observations et prévisions, pg-catalog (PostgreSQL 16) pour le catalogue GeoServer en JDBCConfig. Les providers WMS externes (NASA GIBS, EUMETSAT, DWD, KNMI, MSC GeoMet) passent par GeoServer en cascade, ce qui les met derrière le même cache de tuiles S3 et le même paramètre TIME.

Multi-source ingestion — le détail par source

Architecture
Loading diagram…
Sept familles de pipelines indépendantes, qui finissent toutes par alimenter le même slider temporel côté frontend.

Les cinq premières familles se ressemblent : on télécharge, on convertit, on stocke, GeoServer sert. Les deux dernières répondent à des questions différentes, et méritent d'être lues séparément.

La cascade WMS est le modèle inverse. Quinze couches — les radars DWD, KNMI, NEXRAD, MSC GeoMet, les satellites EUMETSAT et les produits NASA GIBS — ne sont jamais téléchargées. GeoServer est déclaré client du WMS distant (wmsstore) et republie ses couches sous notre espace de noms (wmslayer) ; le navigateur ne parle toujours qu'à nous, et GWC met en cache les tuiles rendues sur le blobstore S3. Le provisionnement est un job PostSync ArgoCD qui, depuis septembre 2026, crée seulement ce qui manque : la version précédente supprimait store et layers avant de les recréer, et un POST de layer qui échouait ensuite laissait la couche morte derrière un job vert.

Le vrai coût de ce modèle est le temps. GeoTools ne transmet pas le paramètre TIME à l'amont sur une couche cascadée : quel que soit l'instant demandé, on recevait la même image, et l'animation des radars était figée. D'où le plugin Java maison décrit plus bas. Et il reste une dépendance qu'aucun code ne supprime : une couche relayée ne vaut que ce que le fournisseur publie à cet instant. Quand EUMETSAT s'est figé vingt heures le 8 septembre 2026, la plateforme n'avait rien de cassé — c'est le canary qui a dû apprendre à dire WARN plutôt que FAIL, parce qu'un garde-fou qui crie au loup pour le voisin ne vaut plus rien.

Les observations ponctuelles, elles, ne sont pas des services. METAR, débits et piézométrie Hub'eau, séismes USGS, feux FIRMS sont des lignes de la table data_sources, exécutées par un orchestrateur qui vit dans l'API NestJS. Ajouter une source, c'est insérer une ligne (URL, parser, sink, expression cron) ; la couper, c'est basculer un booléen. Chaque cycle écrit systématiquement une ligne dans data_jobs, y compris en échec — c'est là qu'on voit qu'Hub'eau renvoie 2000 mesures par quart d'heure dont un bon millier sont rejetées à l'insertion.

La subtilité qui fait perdre du temps : tout ce qui est dans cette table n'est pas orchestré, et tout ce qui est orchestré n'y est pas forcément. Les ingesters historiques (AIS, foudre, SST, modèles météo, bouées) y figurent avec un planning nul et un enabled à faux — purement descriptif, pour que le dashboard admin liste tout au même endroit ; ils embarquent leur propre planificateur. À l'inverse, GloFAS est déclenché par un CronJob Kubernetes, les FIR et les aéroports par un cron hebdomadaire interne à l'API, et les SIGMET/TAF par un simple relais nginx sans stockage. Ne pas trouver une source dans data_sources ne dit rien sur son état.

GloFAS mérite sa parenthèse côté raster : les données CEMS ont migré du CDS vers l'EWDS en 2024, la licence du jeu de données doit être acceptée manuellement sur sa page avant que l'API ne réponde, et le produit n'existe qu'en GRIB2 — dont le gabarit de définition employé n'est pas décodé par le lecteur GRIB de GeoServer. On convertit donc en amont, une image par échéance de J+1 à J+7, servies en mosaïque temporelle.

La rétention a été standardisée en mai 2026, une fois que les TTL bricolés par service ont commencé à diverger. Deux régimes, un seul pour toutes les layers :

  • Observations (SST, satellites, foudre, METAR, Hub'eau, séismes, FIRMS, bouées, navires, alertes) : 7 jours de passé, 0 futur.
  • Prévisions (vent, vagues, flèches, particules) : 7 jours de passé + 7 jours de futur.

Le ménage est fait par un CronJob quotidien (maritime-retention-cleanup) qui purge à la fois les lignes en base et les fichiers du volume /coverage ; chaque fetcher Python garde en plus sa routine cleanup_old_files() en début de cycle. Il n'y a pas de TimescaleDB sur ce cluster : les premières versions du schéma en dépendaient, mais l'extension n'a jamais réussi à cohabiter avec l'UID de CloudNativePG. Ce qui reste est un jeu de stubs SQL no-op (create_hypertable, add_retention_policy…) qui laissent le code d'origine tourner sans erreur — Postgres + PostGIS suffisent à la volumétrie réelle, et la rétention est passée côté CronJob. Un exemple de dette assumée et documentée plutôt que cachée.

Particularités intéressantes

  • Time slider globale [-7j, +7j] pilote toutes les layers simultanément avec snap-to-latest (TIME=1970/cursor range) pour qu'aucune layer raster n'affiche jamais "rien" si le timestep exact n'existe pas. Règle posée depuis : pas de fallback silencieux — si les timestamps sont vides ou la fenêtre invalide, l'UI le dit au lieu d'inventer un pas d'une heure (sept heures de debug stérile en 2026, la ligne fautive a été supprimée).
  • Replay temporel des navires via SQL view paramétrée GeoServer vessels_at_time(at, window) — JDBC virtual table avec DISTINCT ON (mmsi) ORDER BY ts DESC, le frontend appelle WFS avec viewparams=at:ISO;window:300.
  • Palettes utilisateur (sprint 5 APEX) : auth JWT + chaque user peut créer jusqu'à 5 palettes SLD couleur custom → mirror automatique en styles GeoServer user_<id>_<slug> via REST POST/PUT, frontend injecte &STYLES=aetherwx:user_42_marine par user par layer (le workspace GeoServer maritime:* a été renommé aetherwx:* au rebrand — un rename atomique, deux sed distincts, cf les pièges plus bas).
  • Cluster GeoServer 3 replicas avec catalog ET data dir partagés en Postgres (JDBCConfig + JDBCStore), Hazelcast gs-hz-cluster pour propager les événements de catalog entre replicas (une modif de style sur le pod A est visible sur B et C en moins d'une seconde), cache de tuiles GWC posé sur un bucket S3 SeaweedFS partagé — une tuile rendue par un pod est servie du cache par les deux autres. Le Service K8s geoserver:8080 load-balance : le rollout single → cluster n'a touché aucun des services métier qui appellent http://geoserver:8080/.
  • Alerts engine souscrit ais.positions + lightning.strike, applique 2 règles (high-wind sur cargo/tanker dans zone >10 m/s, lightning à <10 km d'un navire actif), publie sur exchange alerts.maritime avec routing key <severity>.<kind>. Cooldown 30min par (mmsi, kind) pour éviter le spam.
  • Vent particules style windy.com / Earth Nullschool : d'abord 1500 particules en canvas 2D advectées par interpolation IDW sur les 4 plus proches voisins du grid GFS, puis — au passage sur le globe MapLibre — un custom layer WebGL (port du webgl-wind de Mapbox, licence ISC) où l'advection se fait dans un shader sur une texture de positions. 3000 particules par défaut.
  • Exposition publique HTTPS via Cloudflare Tunnel sortant (le serveur appelle Cloudflare, pas l'inverse) — zéro port ouvert sur la box, SSL auto, CDN devant les tuiles WMS (une Cache Rule sur les GetMap fait passer les tuiles chaudes de DYNAMIC à HIT et soulage la machine). Domaine sladoire.dev chez Cloudflare Registrar (~12$/an), la carte est sur aetherwx.sladoire.dev.

Le process avec Claude Code

Démarrage en pair sur du dialogue : "je veux un truc avec OL + cluster GeoServer + RMQ comme au boulot, mais pas en météo aviation". Choix domaine maritime collectif, scope initial Bretagne, première étape scaffold sprint 1 en 2h. À partir de là, ~3 sprints/jour pendant 2 jours, le slider temporel ayant débloqué la vision (sprint 3.5) : "tout pilote le temps, on ajoute des sources qui ont du sens à timeshifter".

Pattern le plus impactant : multi-agent en background pour paralléliser des sprints indépendants. Sprints 9 (cluster GeoServer JDBCConfig) + 11 (AROME Météo-France) + un fix ol-companion 2e jaune→rouge dérivé ont été livrés en parallèle par 3 agents pendant que je codais sprint 8 (particules vent) en main — ~1h wall-clock pour 4 livrables. Ça demande de bien briefer chaque agent sur les fichiers à éviter (conflits possibles sur map.component.ts) et de git status avant commit, mais c'est une vraie multiplication.

Aussi : APEX pour le sprint 5 (auth + palettes user) qui était structurant et méritait l'analyze → plan → execute → validate détaillé. Les autres sprints courts (6/7/10) en main-coding direct. Le mix marche bien : APEX pour les gros chantiers, hand-code pour l'itération rapide. /save en fin de session pour capturer 7 memories techniques (pièges GeoServer, rioxarray orientation, IDW pour smooth, Drizzle vs Prisma, etc.).

Sprint Auth refonte — du minimal au full-featured

Le sprint 5 livrait un auth minimal (email + password + JWT 24h) suffisant pour le CRUD palettes user. Quelques sessions plus tard, besoin d'élargir : RBAC admin pour gérer les comptes, vérification email pour limiter le spam, Google OAuth en complément du mdp, suppression auto des comptes dormants. 5 phases livrées en une grosse session (~6h pair-coding), brique par brique, chaque phase poussée séparément.

  • P1 — Schema + RBAC + seed admin : ALTER TABLE users idempotent (5 colonnes ajoutées : username, role, email_verified_at, last_login_at, verification_token). Backfill username = email local-part avec suffix _N si collision via PL/pgSQL DO $$. @Roles('admin') decorator + RolesGuard NestJS (Reflector + SetMetadata). AdminSeedService OnModuleInit qui promote sylvain.ladoire@gmail.com en admin idempotent au boot — pas besoin de lancer un script manuel.
  • P2 — Vérification email Resend : SDK Resend (free 3000 mails/mois, signup sans CB). MailService avec mode dégradé "log only" si RESEND_API_KEY vide (utile en dev). Token UUID 24h, endpoint GET /auth/verify idempotent. Frontend register affiche un écran "vérifie ton email" + bouton "Renvoyer le mail".
  • P3 — Admin UI /admin/users : backend AdminUsersController protégé par @UseGuards(JwtAuthGuard, RolesGuard) + @Roles('admin') au niveau classe. 3 endpoints : list / setRole / delete. Garde-fous serveur : un admin ne peut pas se rétrograder ni se supprimer (anti-brick). Frontend Angular avec table responsive + boutons "Promote", "Demote", "Suppr" + confirm + indicateur "tu" sur self.
  • P3.5 — Google OAuth (passport-google-oauth20) : GoogleStrategy NestJS + 2 endpoints GET /auth/google (302 vers Google) + GET /auth/google/callback (return + sign JWT). Le token est passé au frontend via URL fragment (#token=...) — les fragments ne sont PAS envoyés au serveur, moins de fuite logs vs query string. AuthService.loginOrCreateGoogleUser : merge by email si existe (update last_login_at), sinon create avec username généré + random password + email_verified_at = now (Google a déjà vérifié).
  • P4 — Cron dormants 3 mois : @nestjs/schedule v5 (compat Nest 11) avec @Cron(EVERY_DAY_AT_3AM, timeZone: 'Europe/Paris'). Critère COALESCE(last_login_at, created_at) < now - 90j — comptes jamais connectés sont aussi nettoyés. Admins jamais supprimés (anti-brick). Mode DORMANT_DRY_RUN=true pour audit avant prod.

Le pattern récurrent qui a marché : chaque phase = un commit isolé + push immédiat. Plus simple à reviewer, plus simple à revert si une phase casse. La phase Google OAuth a touché 13 fichiers (back + front) — un seul commit, mais clean dans son scope, et les autres phases déjà sécurisées avant.

Sprint Layer UX V2 — groupes, opacity, reset, forgot password

Suite du sprint Auth refonte. Sylvain ouvre la legend et constate 12 toggles à plat, sans hiérarchie ; il propose un regroupement par catégorie de data. Cinq phases livrées en 1 session de pair-coding (~6h), même pattern « 1 phase = 1 commit isolé » que l'auth refonte.

  • Phase A — Layer groups + opacity slider : refactor de la legend en 5 groupes (Info maritimes, Modèles océano, Modèles atmo, Radar, Foudre) + un placeholder "Satellite à venir". Chaque layer reçoit un slider d'opacité 0-100% visible quand le toggle est actif (`@if (showXXX())` dans le template). Bind sur layer.setOpacity() côté OL. Particules vent = opacity CSS sur le canvas overlay (signal séparé du rAF loop). Bouton « ↺ Réinitialiser » qui restore les defaults visibility/opacity + clear localStorage. Persist localStorage maritime.layer-prefs-v1 sur chaque change.
  • Phase B — Forgot/reset password (Resend) : termine l'auth refonte avec la P5 manquante. Schema password_reset_token + password_reset_expires_at. Token UUID v4 TTL 1h. AuthService.forgotPassword(email) renvoie un message générique (anti-énumération OWASP) quoi qu'il arrive. Bonus dans resetPassword : si l'email n'était pas vérifié, on valide automatiquement — l'user a prouvé qu'il contrôle l'email en cliquant le lien.
  • Phase C — Backend prefs étendu : user_layer_preferences gagne 2 colonnes visible BOOLEAN + opacity REAL (nullable — NULL = défaut app). Endpoints PUT /me/layer-state (single layer, pour debounce 500ms du slider) et PUT /me/layer-states (batch sync au login depuis le localStorage anonymous). Le layerKind accepte n'importe quel string (visible/opacity pour TOUTES les layers), tandis que la palette reste contrainte aux rasters VALID_LAYER_KINDS.

Architecture localStorage-first : Phase A persiste en localStorage pour les anonymous users, Phase C ajoute le sync DB pour les connected. Au login, le frontend merge le localStorage (state actuel browser) avec la DB (state cross-device). C'est l'inverse du pattern « DB first, localStorage cache » classique — ici l'anonymous a 100% des features sans backend, le DB devient une couche optionnelle pour la portabilité.

Pivots & lessons learned

  • Bug orientation GeoTIFF : 1h de débug sur SST avant de comprendre que xarray défaut lat ascending → rio.to_raster écrit Origin = coin sud-ouest. Fix sortby('lat', ascending=False) avant set_spatial_dims. Le même piège a frappé wind/waves (memory écrite).
  • NEAREST strategy silencieuse : sprint 4a wind/waves publiés mais invisibles côté WMS GetCapabilities. Cause : defaultValue.strategy=NEAREST sans referenceValue lève une ServiceException qui SKIP la layer silencieusement. Fix : utiliser MAXIMUM par défaut.
  • Drizzle > Prisma quand DB partagée : sprint 5 ajoutait 3 tables à une DB Postgres déjà peuplée de tables d'autres services. Prisma aurait introspect tout et risqué de drifter ; Drizzle SQL-first ne touche que ce qu'on déclare. Réutilisable si on ajoute du Nest à finance ou warhammer.
  • IDW smoothing pour particules : v1 sprint 8 utilisait nearestWind (snap discret) → trajectoires en zigzag visible aux frontières de cellule. v2 (8b sur feedback user "trop rapide + arrondir les angles") : interpolation IDW pondérée par 1/d² sur les 4 plus proches voisins + advectScale ÷ 4. Champ vectoriel C¹ continu, courbes naturelles.
  • Cluster GeoServer non-breaking : marathon 2026-05-24 passe de 1 à 2 replicas GeoServer (3 aujourd'hui) synchronisés par Hazelcast K8s (plugin community gs-hz-cluster) — RBAC ServiceAccount + Role pod-reader, gossip TCP 5701 sur Service headless. JDBCConfig partagé en Postgres (CNPG pg-catalog) ; le cache GWC est posé sur un bucket SeaweedFS S3 partagé (maritime-gwc-tiles) pour zéro re-cache à froid lors d'un rolling restart. Le Service ClusterIP K8s geoserver:8080 load-balance, donc les 6 sidecars fetchers + l'API + le frontend n'ont aucune modif à faire — l'alias DNS K8s est l'arête stable. Le passage à 3 replicas a attendu le serveur bare-metal : sur la machine précédente (24 Go de RAM partagés avec Windows), trois heaps GeoServer ne tenaient pas.
  • Rétention alignée : un audit a révélé que les purges en base étaient faites mais que les fichiers disque GeoTIFF / GeoJSON s'accumulaient sans limite. Sprint 10b a ajouté cleanup_old_files() dans chaque fetcher Python, puis la politique a été unifiée (7j observations / 7j+7j prévisions) dans un CronJob unique qui traite base et disque ensemble. L'invariant qui en découle et qu'on vérifie depuis : ce que montre la time-bar doit correspondre à de la donnée réelle, et aucune donnée en base ne doit être invisible depuis la time-bar.
  • Bonus pédagogique : Cloudflare Tunnel pour exposition publique. Le serveur reste sur le LAN sans port ouvert, mais https://aetherwx.sladoire.dev est accessible mondialement avec SSL + DDoS protection + CDN cache des tuiles, 0€/mois (juste ~12$/an le domaine). Pattern réutilisable pour les autres apps de la maison — avec un revers découvert plus tard : le connecteur du tunnel vit dans le cluster, donc quand le cluster gèle, le site répond « Cloudflare error 1033 » et rien d'autre.
  • GeoServer community extensions : snapshot ≠ release. JDBCConfig + JDBCStore plantent en 404 sur SourceForge /extensions/ et sur build.geoserver.org/.../community-latest/. Première tentative avec le ZIP snapshot geoserver-2.28-SNAPSHOT-jdbcconfig-plugin.zip → NoClassDefFoundError org/geoserver/util/SortedProperties (le snapshot référence une classe du master dev absente du runtime stable 2.28.2). Le bon chemin : repo.osgeo.org/repository/release/org/geoserver/community/ qui héberge les JARs release tagués alignés au runtime exact. Pour 2.28.3 : gs-jdbcconfig-2.28.3.jar (146 KB) + gs-jdbcstore-2.28.3.jar (61 KB). curl direct au build du Dockerfile, fini.
  • JDBC race condition au boot du cluster : détecté en cours de session quand un agent bg CANDHIS a redémarré les replicas en parallèle. JDBCConfig + JDBCStore lancent CREATE TABLE sans IF NOT EXISTS → gs-1 réussit (premier arrivé), gs-2 plante en relation "resources" already exists → context Spring fail → web app dégradée (REST 404). Fix dans cluster-bootstrap.sh : psql probe au boot (SELECT to_regclass('geoserver.object') IS NOT NULL), si tables présentes → sed sur initdb=true pour le mettre à false avant que GeoServer ne lise le fichier. Premier replica → init, replicas suivants → skip. Élégant + 0 modif au plugin upstream.
  • LB healthcheck 302 false-unhealthy : le LB nginx servait correctement les WMS (200 partout) mais le healthcheck wget -qO- /geoserver/web/ recevait 302 (redirect vers la login UI) → considéré erreur → "unhealthy" perpétuel → provisioner depend_on bloqué. Fix : --max-redirect=0 + accept exit code 8 (server-side redirect status code). Lesson : un healthcheck doit accepter TOUS les codes qui prouvent que le serveur répond, pas juste 200.
  • SeaweedFS server mode bundle vs MinIO maintenance mode. MinIO est entré en maintenance mode (déc 2025), donc SeaweedFS (chrislusf/seaweedfs:3.97) bundle master + volume + filer + S3 gateway dans 1 container via command: server -dir=/data -filer -s3 -s3.config=.... Le flag -filer est obligatoire (sans lui le S3 gateway attend en boucle). Credentials via JSON statique seaweedfs/s3.json. GeoWebCache tile cache vit maintenant dans le bucket maritime-gwc-tiles au lieu du disque local — testé avec aws s3 ls --endpoint-url=http://seaweedfs:8333.
  • Plugin Java maritime-gwc-init — la config GS durable cross-restart. Le vrai pivot architectural du sprint cluster-ready : les REST PUT GeoServer (blobstore, tile layer assignments) sont in-memory only — ils ne survivent pas au redémarrage du pod. L'approche durable ? Un module Maven (geoserver/maritime-gwc-init/) embarqué dans WEB-INF/lib de l'image Docker, avec un bean Spring @PostConstruct qui crée le S3 blobstore + assigne 16 layers GWC au boot, idempotent (check-before-create). Pattern repris de Neo au boulot : la config reproductible vit dans le code, pas dans l'état runtime. Résultat : le cluster rebuild complet en CI restaure exactement la configuration GWC en ~30 s de boot, sans script post-deploy ni intervention manuelle. L'isolation workspace aetherwx-sat (7 layers NASA) a suivi le même schéma : GetCap cold-start 250 ms vs 36 s avant split (le catalog JDBCConfig chargeait tous les layers en un seul GET /ows).
  • Plugin Java maritime-cascade-time-forward — fix un bug GeoTools. Sprint G65 (2026-05-27). Symptôme : l'animation cascade HRV/RSS/MTG/radar affichait toujours la même image quel que soit TIME. Cause racine trouvée en lisant gt-wms (538 + 215 lignes) : 0 occurrence du mot time case-insensitive. GeoTools ne forwarde tout simplement pas &TIME=... à l'upstream pour WMSLayerInfo cascade — par design, pas un bug de config. Approches échouées avant de trouver le bon point d'extension : REST PUT (500 UnsupportedOperationException), SQL UPDATE direct sur le blob XStream (silent no-op), HTTPClientFactory SPI (ordering FactoryRegistry non garanti), BeanPostProcessor sur ResourcePool (GS ne l'expose pas comme bean Spring direct). Solution finale : remplacer le champ privé ResourcePool.wmsCache (un SoftValueHashMap) via réflexion par une HashMap custom qui override put() pour auto-wrap le WebMapServer.httpClient. Couplé à un DispatcherCallback.operationDispatched() qui stash TIME du KVP dans un ThreadLocal et un décorateur HTTPClient.get(URL) qui réécrit l'URL upstream avec &TIME=.... 11 commits de marathon dont 4h coincées sur le pitfall "init() fire AVANT parse KVP donc request.getService() est null". Validation prod : HRV à 08:00/10:00/12:00/14:00 UTC → 4 md5 distincts (avant 1 seul). Le pattern « wrap cache via réflexion » est réutilisable pour toute interception HTTP outbound GS (auth headers, retry, rate limiting, mock pour tests).

Plugin WPS custom — densification IDW (2026-05-13)

Les rasters source météo / océano sont sur grille grossière : GFS 0.25° (~28km), OISST 0.25°, WW3 0.5°. Au rendu, on voit les pixels — pas joli, et les isolignes ras:Contour sortent en escaliers. La solution classique = densifier le raster côté serveur avant la color map. Mais il ne faut surtout pas pré-sampler les données (les rasters source doivent rester intacts pour GetFeatureInfo / WCS time series). Donc : densification rendering-side uniquement.

On a écrit un plugin Java GeoServer WPS qui expose deux processes custom :

  • idw:IDW — Inverse Distance Weighting raster densifier. Paralléle sur les rangées dst (IntStream.range().parallel()), fast paths pour p=1 (linear) et p=2 (squared, skip Math.pow), Math.fma pour les sommes pondérées, factory cache static final. ~150 lignes Java 17.
  • idw:IDWContour — appelle IDWProcess.execute() puis ContourProcess.process() de GeoTools en interne, retourne la FeatureCollection des isolignes lisses. Pourquoi pas un chaining SLD natif ? Voir bug ci-dessous.

Le bug GeoTools post-2.26.2 — débuggé avec Claude en miroir

Je connaissais le bug depuis un projet pro avec un autre Claude — il avait fini par trouver la régression dans les sources GeoTools, commit d'Andrea Aime (le mainteneur historique). En SLD avec rendering transformation, la syntaxe <Function name="parameter"><Literal>data</Literal></Function> sans valeur déclenche une auto-injection du coverage source côté pipeline de rendu. Sauf qu'à partir de GeoTools 32 (= GS 2.26.2), si le process bean Java ne contient AUCUNE des méthodes invertGridGeometry / invertQuery / customizeReadParams / clipOnRenderingArea, AnnotationDrivenProcessFactory.create() wrap le process en plain ProcessFunction au lieu de InvokeMethodRenderingProcess — l'auto-injection ne se déclenche plus, data arrive null, et l'execute() jette "Parameter data is missing but has min multiplicity > 0".

Fix dans le plugin : ajouter une méthode publique public GridGeometry invertGridGeometry(Query, GridGeometry) qui retourne le target tel quel. Sa simple existence détectée par réflexion suffit à déclencher le bon wrapping. Pas d'implements RenderingProcess requis — la réflexion sur le nom de méthode est plus permissive que l'interface elle-même.

Le chaining SLD reste cassé entre processes externes même avec le fix : ras:Contour avec un idw:IDW nested dedans → le inner ne reçoit toujours rien (GS n'auto-injecte que sur la transformation externe). D'où idw:IDWContour qui internalise les 2 étapes — un seul process, plus de chaining, plus de bug.

Le piège JDBCConfig — 1h perdue avant de comprendre

Le cluster GeoServer utilise JDBCConfig (catalog Postgres-backed) pour que les replicas partagent le même état. Quand on PUT un SLD via REST API (PUT /rest/workspaces/<ws>/styles/<name>?raw=true), la DB est bien mise à jour, et un GET sur la même URL retourne la nouvelle version ✓. Mais le rendu continue d'utiliser l'ancienne version — pourquoi ?

Réponse : GeoServer charge les SLDs depuis le filesystem (workspaces/<ws>/styles/<name>.sld), pas depuis la DB. Les REST writes à JDBCConfig ne ré-écrivent pas les fichiers SLD sur disque — ils restent stales. POST /reload recharge le catalog depuis DB mais pas les fichiers SLD. Donc tant qu'on ne docker cp pas le SLD dans chaque replica, le rendu reste figé sur l'ancienne version — alors même que tous les indicateurs catalog disent "à jour".

Workaround durable : un script deploy-style.sh qui fait les 3 étapes (REST PUT + docker cp dans les N replicas + POST /reload). Idempotent, déployable en CI/CD. Le drift catalog ↔ disk n'est pas documenté côté GeoServer — leçon à graver dans la mémoire des projets cluster JDBCConfig.

Suite de l'histoire, quatre mois plus tard : ce script est devenu un job de bootstrap au démarrage, et il a fallu le réécrire deux fois. Version 1, destructive : DELETE puis POST puis PUT à chaque exécution, avec un timeout client de 30 s. Or un timeout côté client n'annule pas la requête côté serveur — sous contention du catalog partagé, le DELETE passait, le client abandonnait, le PUT n'arrivait jamais, et le style se retrouvait décrit mais vide. Version 2 : plus aucun DELETE, une synchronisation par comparaison (on lit, on saute si identique, on écrit sinon), une relecture bit à bit après écriture, et un code de sortie non nul dès qu'un style échoue — y compris ceux qui ne sont style par défaut de personne, dont l'échec était jusque-là avalé.

Burst protection — control-flow extension

Le frontend tuile en 256×256 — un pan de carte peut burst 30+ requêtes WMS GetMap en parallèle. Avec une rendering transformation coûteuse (IDW densify × Contour), le pool de threads Tomcat saturait → LB nginx en upstream timed out → cascade de 502 → GeoServer s'effondrait pendant 1-2 minutes. Solution : l'extension stable control-flow (Andrea Aime aussi, par contre celle-là est documentée). On a calibré pour quad-core × 2 replicas Hazelcast : ows.global=16, ows.wms.getmap=6, user=8, timeout=30s. Les requêtes excédentaires partent en file plutôt que de tuer le serveur.

Burst test validé : 30 requêtes WMS concurrentes → 30/30 réponses 200, P95 = 6s (sous le timeout 30s), zéro 502, zéro effondrement.
Septembre 2026 — le serveur bare-metal

Pendant l'été, la prod tournait sur « Mini-Blue » : un mini-PC Windows, cluster k3s dans WSL2. Ça a tenu quelques mois, puis les gels se sont rapprochés — toutes les 48 heures environ, le cluster se figeait entièrement. Comme le connecteur Cloudflare Tunnel vit dans le cluster, le symptôme côté visiteur était toujours le même : Cloudflare error 1033, tunnel introuvable. Le site est resté down trois semaines.

La cause racine n'était pas la RAM, comme on l'a d'abord cru (l'hypothèse facile quand un WSL sature) mais l'épuisement des watches inotify : fs.inotify.max_user_instances vaut 128 par défaut, et entre containerd, kubelet, les operators et les sidecars, un cluster k3s complet passe cette barre sans effort. Le symptôme visible était une erreur 1033 ; le vrai message était dix couches plus bas. Fix sysctl.d → 1024, mais la leçon a surtout servi à trancher une question de fond : une prod ne devrait pas vivre dans un sous-système Linux d'un poste de travail.

D'où dark-blue, assemblé début septembre et migré le 03/09/2026 : Ubuntu 26.04 bare-metal, Ryzen 9 9900X, 64 Go DDR5, NVMe 3,6 To, RTX 4080 (réservée au transcodage Plex — le GIS ne l'utilise pas), k3s v1.36.4, ArgoCD, Longhorn, CloudNativePG, cert-manager, ingress-nginx. Un seul cluster, plus de dual-cluster à garder synchrone.

Architecture
Loading diagram…
La topologie depuis septembre 2026 : un seul cluster de prod bare-metal, le poste de dev ne fait plus tourner de prod. Le NAS est redevenu ce qu'il aurait dû rester — du stockage et des sauvegardes.

Ce que la panne a appris, au-delà du sysctl : un fix appliqué à chaud sans passer par le dépôt GitOps est une bombe à retardement. Plusieurs correctifs de fetchers avaient été posés directement sur le volume de prod sans bump du tag dans le gitops ; au redéploiement à neuf, ils ont tous disparu d'un coup et sept layers modèle sont revenues à zéro. Depuis, un correctif runtime n'est considéré fait que quand le tag est épinglé dans le dépôt.

GeoServer 3.0.1 — migrer sans migrer le catalog

Le 08/09/2026, la prod est passée sur GeoServer 3.0.1 (GeoTools 35.1, GWC 2.0.1, Tomcat 11, Java 21, ImageN à la place de JAI). La stratégie tient en une phrase : ne pas migrer le catalog.

Une migration de data dir 2.x → 3.x est irréversible et se debug mal. À la place : un schéma PostgreSQL neuf (geoserver3) et un volume neuf, rebootstrappés par les mêmes jobs idempotents qui recréent déjà workspaces, stores, layers et styles au démarrage. Le catalog 2.28 et son volume ne sont jamais touchés, donc le rollback est un git revert du commit de values (tag + schéma + volume) — pas une restauration de sauvegarde. Le tout derrière un drapeau Helm, répété d'abord dans un namespace jetable avec une copie des rasters, puis flippé en prod.

  • Zéro ligne de Java changée dans les trois plugins maison (IDW, cascade time-forward, init GWC) — vérifié dans les sources de GeoTools 35.1 plutôt que supposé. La méthode marqueur invertGridGeometry ajoutée un an plus tôt était déjà la bonne pour le chaînage raster ; invertQuery ne concerne que les process vecteur.
  • Boot ~2 min par pod contre 10 à 20 min en 2.28. Le startup probe hérité (20 min de grâce) a été ramené à 5, et une readiness probe a été ajoutée — les trois replicas n'en avaient aucune, ce qui veut dire qu'un pod en cours de boot recevait du trafic.
  • Rendu identique au pixel près entre 2.28 et 3.0.1 sur les rasters IDW et les isolignes : la comparaison a été faite image par image, pas à l'œil.

Les deux pièges les plus coûteux étaient invisibles depuis l'application. Le premier : le catalog « 2.28 » ne vivait pas dans le schéma geoserver qu'on croyait, mais dans public — le script d'init tournait en superutilisateur, le schéma appartenait donc à postgres, l'utilisateur applicatif n'avait pas le droit USAGE dessus, et PostgreSQL saute silencieusement un schéma inaccessible du search_path. Deux ans de catalog rangés ailleurs que là où la config le disait, sans un seul message d'erreur. Le second : un interblocage de déploiement — trois exécutions en échec du CronJob de surveillance (une panne de radar antérieure) suffisaient à faire marquer la synchronisation comme non réussie par ArgoCD, donc à ne jamais déclencher les hooks qui remplissent le catalog. Trois pods parfaitement Ready, servant un catalog vide.

Ce qui a bougé en septembre

  • Trois sources radar / précipitations (07/09) : radar NEXRAD pour les États-Unis (via l'Iowa State Mesonet), radar MSC GeoMet pour le Canada, et précipitations globales NASA GIBS IMERG. Le groupe Radar passe de 3 à 6 entrées (RainViewer global, DWD, KNMI, NEXRAD, GeoMet, IMERG). Chacune a sa propre cadence et sa propre fenêtre d'archive — 5 min et plusieurs jours pour NEXRAD, 6 min mais seulement ~3 h glissantes pour GeoMet, 30 min avec ~7 h de latence d'ingestion pour IMERG. Ces trois valeurs ne sont pas de la décoration : elles décident du TIME que le frontend a le droit de demander, et une fenêtre mal bornée se traduit par une tuile vide plutôt que par une erreur.
  • Un sélecteur de fonds de carte : trois fonds (Esri Dark Gray par défaut, Esri Satellite, OpenTopoMap), persistés par utilisateur. Le point technique est le swap : on remplace uniquement la source et la layer du fond, jamais map.setStyle() — un setStyle global détruirait la custom layer WebGL des particules et l'ordre des vingt layers WMS empilées au-dessus.
  • Une couche retirée (09/09) : « Satellite IR (RainViewer) ». Le manifeste de RainViewer ne renvoyait plus aucune image infrarouge — satellite.infrared vide sur trois relevés espacés, et les tuiles correspondantes en 404 — alors que leur radar, lui, continuait de publier des images vieilles de quatre à dix minutes. La couche affichait donc du vide depuis un moment sans que rien ne le signale. Règle appliquée telle quelle : une couche qui n'a plus de données récentes se retire, elle ne se laisse pas en place « au cas où ». Le groupe Satellites passe de 11 à 10 entrées ; la couche « Précipitations RainViewer » du groupe Radar reste, elle est alimentée. Le vrai enseignement n'est pas la suppression mais le délai de détection : rien dans la carte ne distingue « la source ne publie plus » de « il n'y a rien à afficher à cet instant ».

Les deux fonds CARTO ont d'ailleurs été retirés le 09/09, et l'histoire vaut d'être racontée. Depuis que CARTO a durci ses conditions, chaque tuile revient estampillée d'un filigrane « API KEY REQUIRED » en diagonale — tout en répondant HTTP 200 avec un PNG parfaitement valide. Aucune supervision qui regarde le code de retour, la taille ou le type MIME ne peut voir la différence : c'est la même signature d'échec que la couche RainViewer ci-dessus, et que les sept copies satellite qui téléchargeaient du noir en rapportant ok. Le filigrane a d'abord été gardé comme exemple pédagogique, jusqu'à ce qu'on réalise qu'il s'était propagé dans les captures d'écran du README — la vitrine du projet. Bascule sur Esri Dark Gray, déjà présent dans le sélecteur, sans clé et visuellement équivalent ; les préférences enregistrées pointant encore CARTO retombent silencieusement sur le nouveau défaut.

La leçon, elle, reste : les sources externes changent leurs règles sans prévenir, et une carte qui en dépend le découvre en production. Ce qui manquait n'était pas la vigilance mais un contrôle du contenu — c'est exactement ce que fait le canary décrit plus bas en comparant les pixels rendus, là où un simple curl -f aurait dit que tout allait bien.

Le garde-fou — une matrice qui ne peut pas dériver

La règle est née d'une régression de trop, formulée telle quelle : « une correction d'un layer ne doit plus jamais casser un autre layer ». Ce qui en est sorti : une matrice des 26 combinaisons layer×style réellement demandées par la carte, générée en parsant les sources du frontend à chaque exécution — donc impossible à laisser pourrir — rejouée par un CronJob canary toutes les 6 heures dans le cluster, plus un test E2E d'animation qui vérifie les invariants du contrat temps.

Le détail du harnais est raconté ici — c'est la partie du projet la plus transposable ailleurs.